Estudo no PLOS ONE mede como imagem ruim de câmera muda as taxas de erro do reconhecimento facial na busca policial
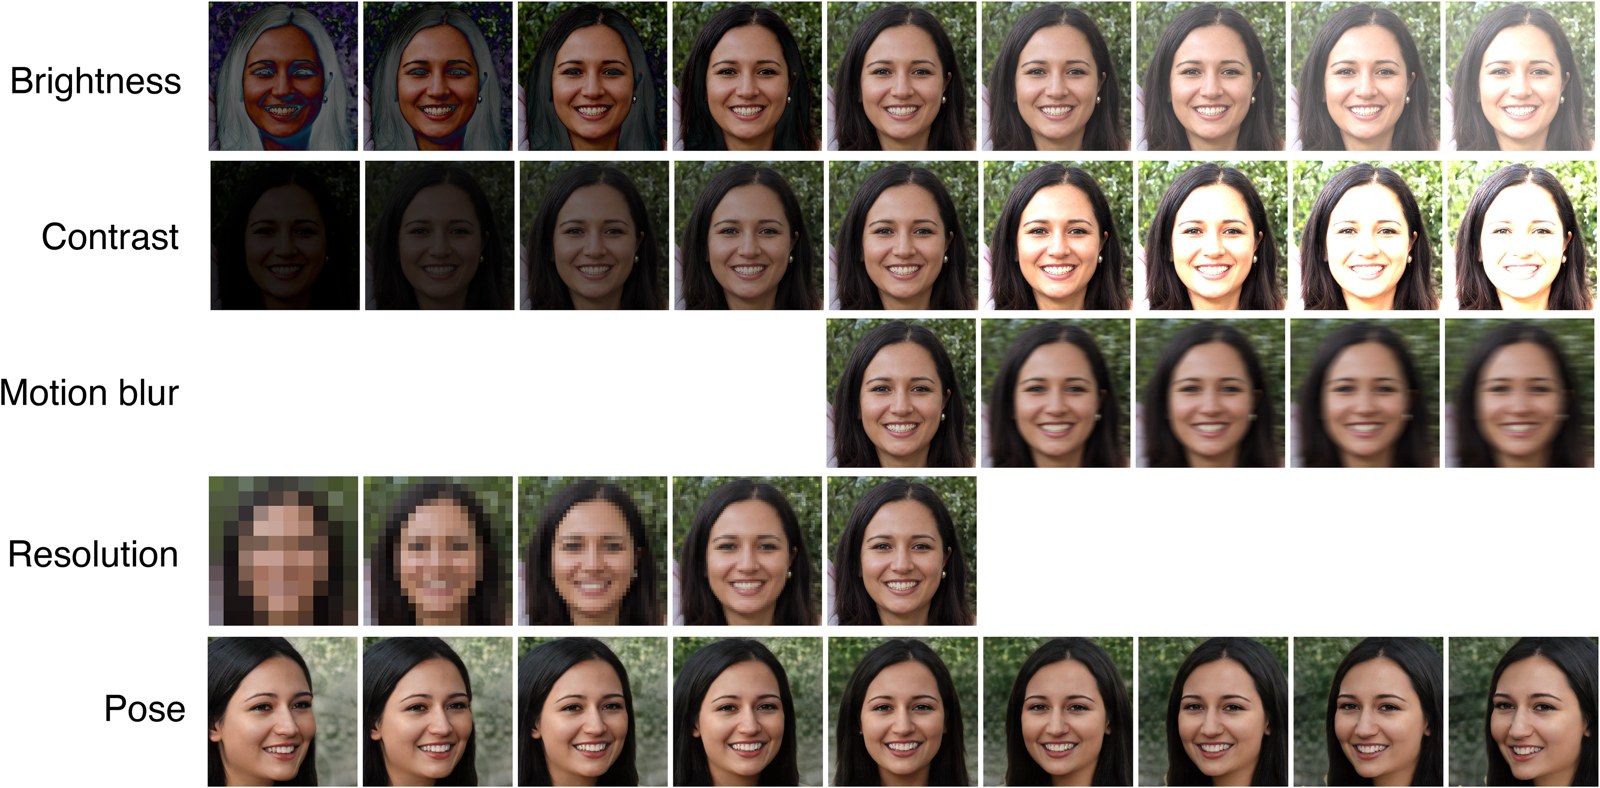
Um experimento publicado em 21 de outubro de 2026 na revista científica PLOS ONE por Maria Cuellar, Hon Kiu (James) To e Arush Mehrotra, da University of Pennsylvania, mostra que a taxa de erro de um sistema de reconhecimento facial muda conforme a qualidade da imagem questionada, e que a imagem de baixa qualidade, comum nas investigações policiais, altera de modo diferente os dois tipos de erro da busca.
O problema que os autores quiseram medir
Os autores partem da constatação de que a maior parte das avaliações de precisão do reconhecimento facial usa imagens de boa qualidade, diferentes das que a polícia costuma ter em mãos, e lembram que, segundo o Innocence Project, há pelo menos sete casos confirmados de identificação errada por reconhecimento facial, seis deles envolvendo pessoas negras acusadas injustamente.
O estudo trata da busca do tipo 1:N, em que uma imagem de pessoa não identificada é comparada com todas as imagens de um banco e o sistema devolve candidatos para revisão humana, e usa as duas taxas de erro próprias dessa tarefa, a taxa de falso positivo de identificação (FPIR), que é a probabilidade de o sistema apontar alguém quando a pessoa procurada não está no banco, e a taxa de falso negativo de identificação (FNIR), que é a probabilidade de o sistema não encontrar a pessoa que está no banco.
O método: rostos sintéticos degradados de forma controlada
Para saber sempre quem é quem, os pesquisadores geraram 50.000 rostos sintéticos com o modelo StyleGAN3, treinado no conjunto de imagens FFHQ, classificaram raça e gênero com a ferramenta FairFace, retiraram os rostos classificados como de crianças com menos de 10 anos e sortearam amostras equilibradas entre homens e mulheres brancos, negros e asiáticos.
O banco de controle tem 167 rostos de boa qualidade, número calculado para uma sensibilidade esperada de 0,99, e a cada rodada outros 167 rostos degradados foram comparados com esse banco, 83 deles com o rosto original presente no banco e 84 sem ele, num total de 256 repetições do experimento, das quais saíram intervalos de confiança de 95%.
Os rostos foram degradados em cinco fatores, um de cada vez e em vários níveis: contraste, brilho, borrão de movimento horizontal, giro da cabeça (pose) e resolução, esta reduzida para até 1% do tamanho original e depois ampliada de volta, para imitar o aspecto quadriculado de imagens de câmeras de segurança e de redes sociais.
O reconhecimento foi feito com a biblioteca de código aberto DeepFace, com o detector RetinaFace e o modelo ArcFace, que os autores escolheram por ser muito usado, público e com bom desempenho nas avaliações do NIST, o instituto americano de padrões e tecnologia, e todos os candidatos com distância de cosseno até o limiar recomendado pelos desenvolvedores foram contados como coincidência, sem corte por número de candidatos, como fazem policiais que revisam todos os resultados acima de certo grau de confiança.
O que o experimento encontrou
A taxa de falso negativo subiu à medida que a imagem piorou, e a resolução reduzida foi o fator com efeito mais forte, enquanto brilho, contraste e borrão tiveram efeitos menores, mas ainda consideráveis, e a pose teve o menor efeito entre os cinco.
A taxa de falso positivo ficou bem acima da de falso negativo no ponto de operação escolhido e chegou ao máximo perto da imagem original, caindo à medida que a degradação aumentou, comportamento que os autores atribuem ao limiar relativamente permissivo recomendado pelo desenvolvedor, que deixa o sistema devolver mais candidatos quando a pessoa procurada não está no banco.
Com isso, a imagem pior não aumentou todos os erros por igual, mas mudou o equilíbrio entre deixar de identificar quem está no banco e apontar alguém quando a pessoa não está nele, e por isso os autores dizem que não dá para avaliar se uma imagem degradada serve para a busca olhando uma taxa só.
Na comparação entre grupos, a taxa de falso positivo foi muitas vezes mais alta para pessoas negras, sobretudo mulheres negras, e mais baixa para homens brancos, com diferenças que diminuíram com a degradação, ao passo que o grupo com mais falsos negativos mudou conforme o tipo de degradação, e a perda de resolução atingiu mais as pessoas negras e asiáticas.
Os limites que os autores apontam
Os autores registram que rostos sintéticos e degradações controladas podem não captar toda a complexidade das imagens reais de vigilância, que foi avaliado um único conjunto de ferramentas e que o resultado pode mudar com outros algoritmos, limiares e bancos de imagens, e que cada fator foi testado isoladamente, embora as imagens reais costumem somar vários defeitos ao mesmo tempo.
A amostra original de rostos gerados era 73% branca, 17% asiática, 5% negra e 5% indiana, herança do conjunto de treinamento, e os autores tratam raça como construção social, com categorias simplificadas que, segundo eles, devem ser refinadas em trabalhos futuros, assim como o efeito do tamanho do banco de imagens, que ficou fora do estudo.
O que isso muda para quem examina uma identificação
Os autores afirmam que o desempenho do reconhecimento facial não deve ser resumido numa única taxa de acerto, porque o erro depende da qualidade da imagem, e propõem as curvas de erro condicionadas à degradação como forma de estimar como o perfil de erro de uma busca muda quando a imagem questionada tem pouco brilho, borrão ou baixa resolução.
O artigo também distingue o desempenho do algoritmo em teste padronizado do desempenho na operação real, que depende do tratamento da imagem, da escolha do limiar, da formação do banco e das decisões de quem usa o sistema, e conclui que mesmo um algoritmo muito preciso pode gerar resultado pouco confiável ou enviesado se for usado sem considerar as limitações da imagem.
Fonte original: PLOS ONE, Maria Cuellar, Hon Kiu (James) To e Arush Mehrotra, 21.Out.2026.
Marcadores: reconhecimento facial, qualidade de imagem, taxa de erro, viés algorítmico, CFTV, Estados Unidos.