Revisão humana pega falsos positivos do reconhecimento facial, mas rende menos nos limiares mais rígidos e muda conforme o algoritmo
O artigo “Detection of false positives by human reviewers depends on the face recognition algorithm and its security configuration”, de Esha Edakoth, John J. Howard, Isabelle M. Shuggi, Yevgeniy B. Sirotin e Robert Wood, foi submetido ao repositório científico arXiv em 16 de outubro de 2026 e resulta de uma pesquisa patrocinada pela Diretoria de Ciência e Tecnologia do Departamento de Segurança Interna dos Estados Unidos (DHS).
O humano que confere a máquina
Nos sistemas de identificação, o algoritmo compara dois rostos, gera uma pontuação de semelhança e declara correspondência quando ela passa de um limiar configurado, e uma pessoa revisa essa decisão antes de qualquer providência, arranjo que os autores chamam de equipe humano-IA com interdependência sequencial, porque o revisor só age depois da máquina.
O limiar é escolhido conforme o nível de segurança desejado, medido pela taxa de falsa correspondência (FMR, false match rate), e os autores lembram que casos recentes de falso positivo no reconhecimento facial levantaram dúvidas sobre a eficácia dessa revisão, muitas vezes feita por pessoal sem treino formal em comparação facial.
Como os pares de rostos foram escolhidos
Para cada um de quatro algoritmos comerciais de desempenho comparável, todos com taxa de falsa não correspondência igual ou inferior a 1% nos limiares avaliados, os pesquisadores calcularam os limiares que produzem FMR de 1 em mil, 1 em 10 mil, 1 em 100 mil e 1 em 1 milhão, usando imagens de alta qualidade, no padrão de foto de passaporte, de voluntários que deram consentimento.
Depois de retirar gêmeos e comparações repetidas, a base ficou com 2.290 imagens de 2.087 pessoas e 8.973.535 comparações, e os pares de pessoas diferentes que o algoritmo considerou parecidos foram separados em três faixas: inferior (FMR entre 1 em mil e 1 em 10 mil), média (entre 1 em 10 mil e 1 em 100 mil) e superior (entre 1 em 100 mil e 1 em 1 milhão).
Em cada faixa entraram os três pares de pessoas diferentes com pontuação mais alta em cada algoritmo, ou seja, os falsos positivos mais difíceis daquela faixa, método que os autores chamaram de amostragem por intervalo de taxa de falso positivo (S-FPRI) e que deu origem ao conjunto DFICT (Difficult Facial Image Comparison Test).
O teste com 801 revisores
Dos 814 voluntários que aceitaram participar, 13 foram excluídos por sinais de que não entenderam a tarefa ou por falha técnica nos iPads usados, e cada um dos 801 restantes, sem nenhum treino em reconhecimento facial, avaliou 12 pares de um único algoritmo: três pares de pessoas diferentes de cada faixa e três pares da mesma pessoa, fotografada em dias diferentes.
As respostas eram dadas numa escala de 7 pontos, de “tenho certeza absoluta de que são pessoas diferentes” a “tenho certeza absoluta de que é a mesma pessoa”, com a opção “não tenho certeza”, e os revisores não viam nenhuma informação sobre a decisão do algoritmo, para que ela não influenciasse a resposta.
A análise usou a teoria de detecção de sinal, que separa a capacidade de distinguir pares iguais de pares diferentes (sensibilidade, indicada por d’) da tendência do revisor a responder “diferentes” ou “iguais” (critério), e os números principais foram calculados com o “não tenho certeza” contado como “pessoas diferentes”.
O que os números mostram
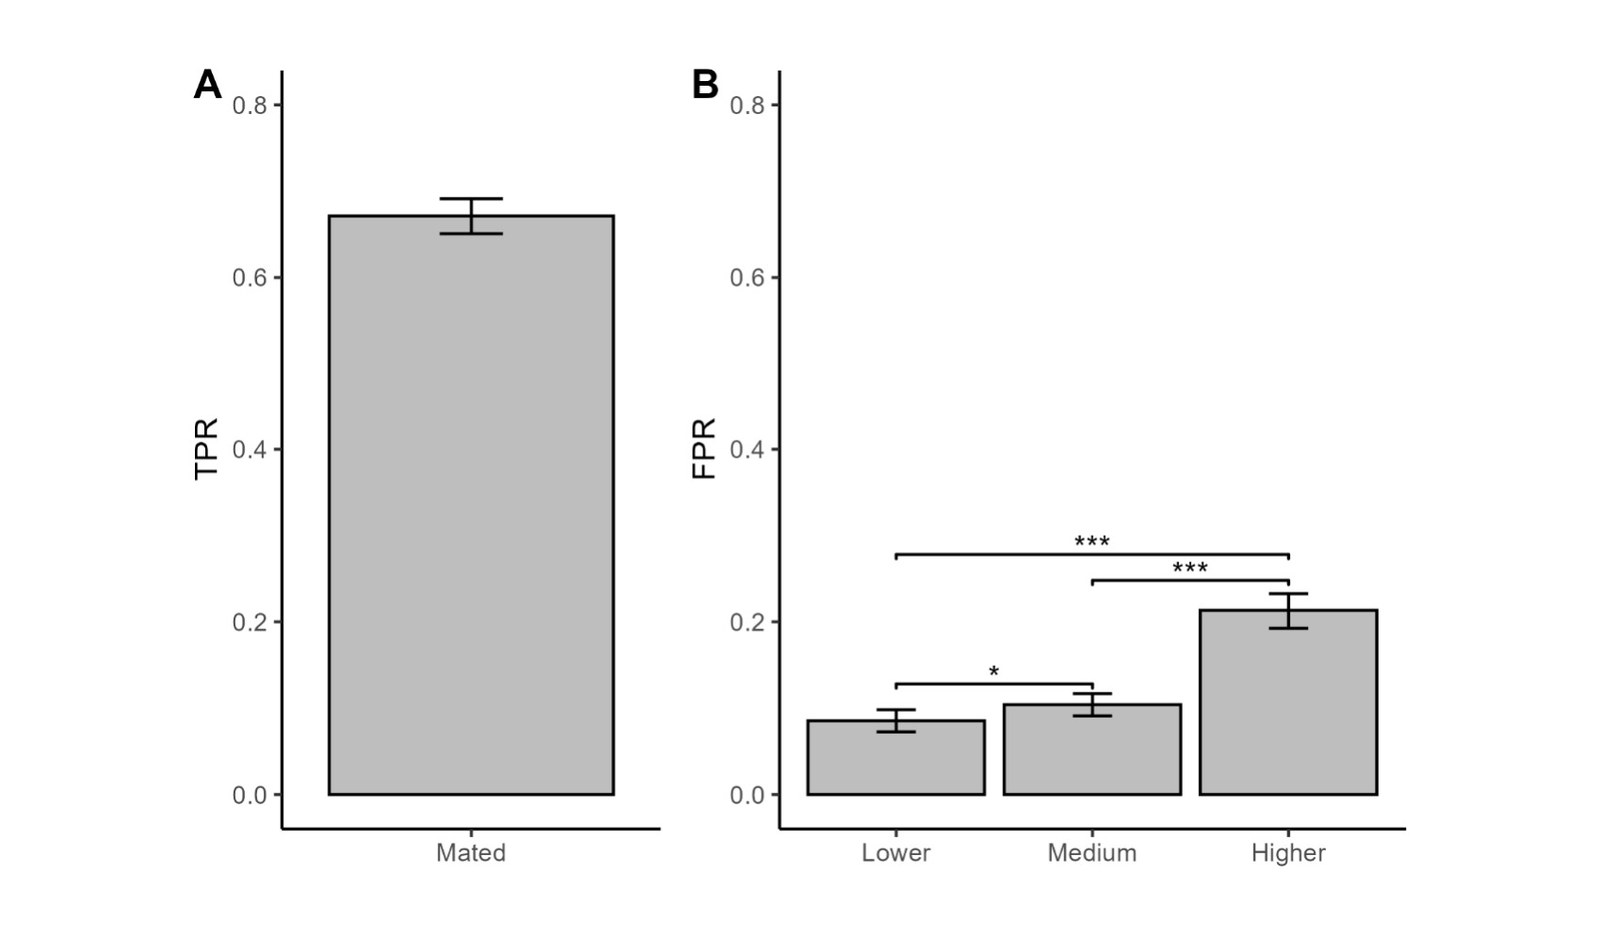
Os revisores reconheceram corretamente 67% dos pares da mesma pessoa e aceitaram como mesma pessoa entre 8,5% e 21% dos pares de pessoas diferentes, taxa que subiu de menos de 10% na faixa inferior para mais de 20% na faixa superior, com diferenças estatisticamente significativas entre as três faixas.
Mesmo na faixa de segurança mais alta, os revisores sem treino detectaram cerca de 80% dos falsos positivos dos algoritmos, o que leva os autores a concluir que a revisão humana reduz de forma significativa os erros dos sistemas comerciais, mas que os limiares mais rígidos, que diminuem os erros da máquina, tornam mais difícil para o humano encontrar os que sobram.
A sensibilidade medida ficou entre 1,24 e 1,81 conforme a faixa, e na faixa superior, com d’ de 1,24, os pares escolhidos pelos algoritmos se mostraram mais difíceis do que os da versão atualizada do Glasgow Face Matching Test (GFMT2), teste de comparação facial cujos pares foram pré-selecionados por um algoritmo aberto e depois escolhidos por revisão de especialistas e notas de leigos, e cuja sensibilidade publicada vai de 1,64 a 1,75.
Os quatro algoritmos tinham desempenho técnico parecido, mas a taxa de falso positivo dos revisores variou quase duas vezes entre eles, e na faixa superior os pares de um dos algoritmos, chamado C no estudo, foram os mais difíceis de distinguir, com a maior queda de sensibilidade entre a faixa média e a superior.
Os limites apontados pelos autores
As imagens eram de alta qualidade, com pose frontal, expressão neutra, iluminação difusa e fundo neutro, e os autores reconhecem que as imagens de uso real tendem a ser piores e que é preciso verificar se o resultado se mantém com elas.
A tarefa reproduz uma verificação um para um, e não a revisão de uma lista de candidatos de uma busca um para muitos, embora os autores esperem que a queda de desempenho se repita na identificação, e a base de referência era pequena perto das galerias operacionais e não forneceu pares abaixo de FMR de 1 em 1 milhão, faixa em que eles esperam desempenho humano ainda menor.
A proporção de nove pares de pessoas diferentes para três da mesma pessoa pode ter puxado as respostas para “pessoas diferentes”, e, no uso real, o revisor costuma receber a decisão e a pontuação do algoritmo, o que, segundo os autores, pode reduzir a chance de ele perceber o falso positivo.
O que os autores propõem para a escolha do sistema
Os autores observam que as normas de ensaio biométrico, como a série ISO/IEC 19795, medem a exatidão do algoritmo e não tratam da revisão humana, e que as diretrizes do Facial Identification Scientific Working Group (FISWG) definem o papel do revisor de listas de candidatos, mas tratam essa revisão como independente do algoritmo e se concentram no procedimento, e não no desempenho do sistema como um todo.
A recomendação do estudo é que, onde a revisão humana for necessária, a capacidade do revisor de pegar os erros do algoritmo entre como critério na escolha do sistema, ao lado do algoritmo, do limiar configurado e do nível de treino exigido do revisor, porque, segundo os autores, algoritmos com exatidão semelhante podem ter grandes diferenças de compatibilidade com a revisão humana.
Fonte original: arXiv, Esha Edakoth, John J. Howard, Isabelle M. Shuggi et al., 16.Out.2026.
Marcadores: reconhecimento facial, falso positivo, revisão humana, limiar biométrico, arXiv.